Microservice ile Transaction Yönetimi
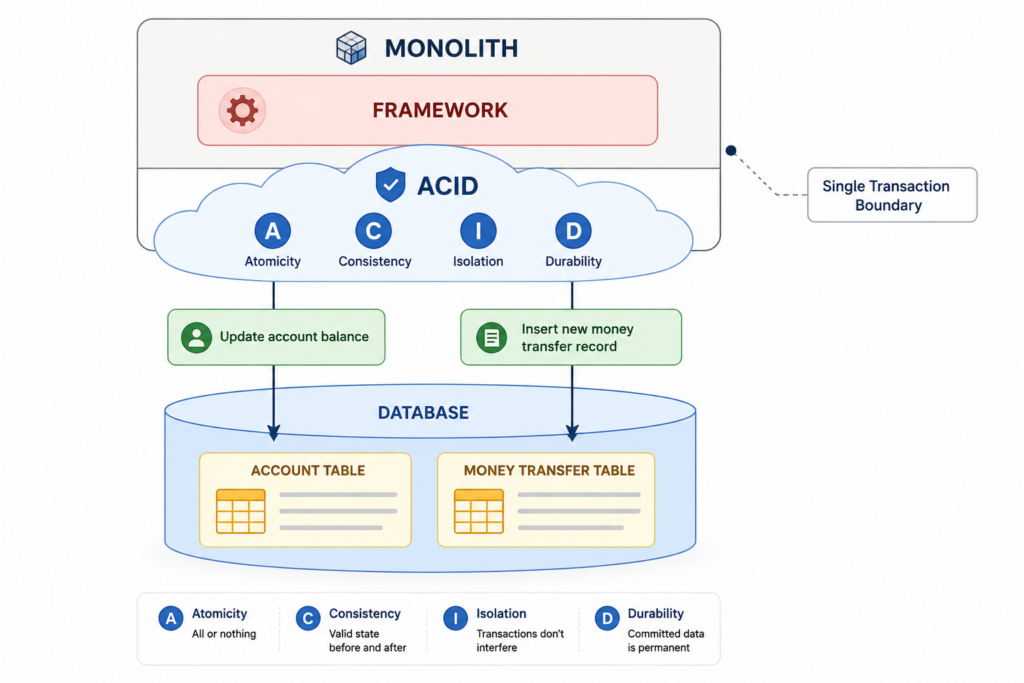
Bildiğiniz gibi Monolithic uygulamalarda farklı entityler üzerinde çalışırken single database üzerinde strong consistency ile inconsistent verileri engelleyebiliyoruz.(bkz: ACID) Elimde Single Transaction Boundary bulunuyor birden fazla database işlemi için transactionı başlatabiliyorum, commitleyebiliyorum veya rollback yapabiliyorum. Hemen bir şekil ile bunu ifade etmeye çalışayım. Geleneksel olarak kullandığımız yöntem aşağıdaki şekildeki gibi.
Microservice mimarisine gelecek olursak. Microservice mimarizdeki beklentimiz olabildiğince loosely coupled olmak bunun kazancı olarak bağımsızlığımızı ilan etmek. Verinin sahipliğini merkezi olmaktan çıkarıyorum ve bunu farklı servislere sorumluluk olarak yükleyerek devam ediyorum bunun yaparken shared resourcelarımda akabinde ayırıyorum.
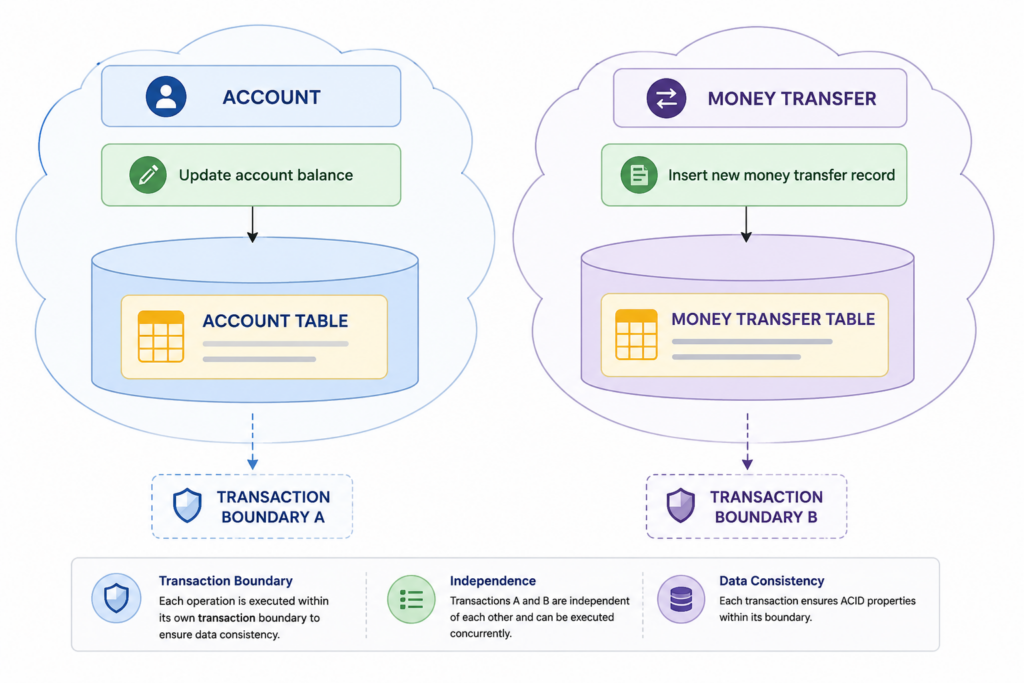
Artık iki farklı bağımsız servisim mevcut, bu ayrım ile birlikte artık servislerimi bir birini beklemeden deploy edebilirim bu sadece bir kazanım daha bir çok kazanımı mevcut bununla birlikte monolith kadar sağlam bir transactiondan yönetimi mevcut olmayacak, yukarıdaki şekilde de görüldüğü gibi update account balance yaparken, insert new money transfer recorduda oluşturmam gerek ama farklı transaction içinde yapmak zorundayım. Böylece Atomicity’yi kaybettim. Distributed sistemlerde bu çözelmesi gereken zor bir sorun. Çünkü bunu çözerken ya consistency’den vazgeçmek zorunda kalıyoruz ya da availability’den.
Bu sorunu çözemek için Distributed Transaction kullanabiliriz. Bunu gerçekleştirmek için two-phase commit (2PC) yöntemini kullanabiliriz.
Two-Phase Commit (2PC)
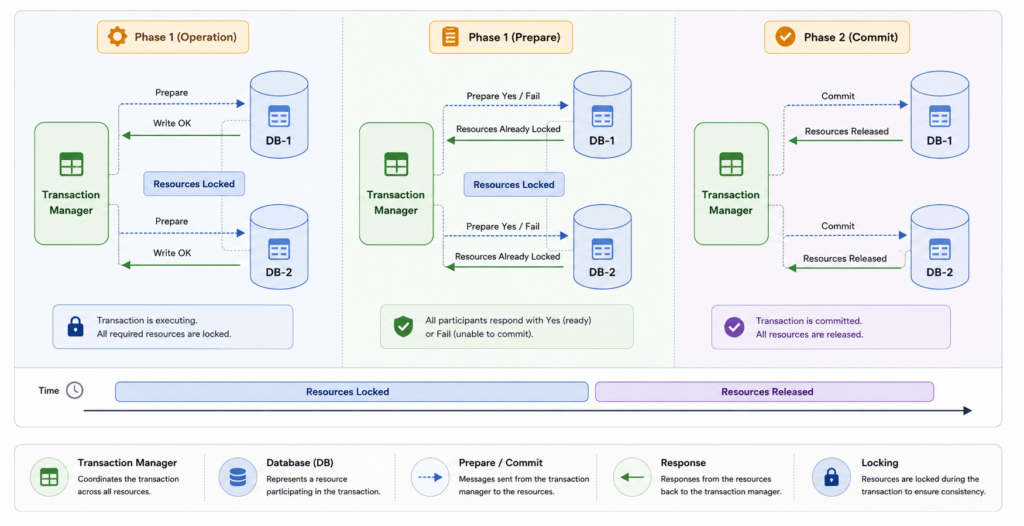
Bu yöntemde olayın göbeğinde bir tane coordinator (transaction manager) bulunmakta ve bununla birlikte çalışan single nodelar(participants) yer almakta. Transaction başladığında her single node (participant) kendi uygulamasında kendi işlemlerini gerçekleştiriyor yani tüm read ve write işlemleri bittikten sonra transaction manager’a gidiyor sonra ise phase 1 başlatılıyor. Coordinator phase 1 de herkese commit edebilecek misiniz bu veriyi diye soruyor herkes cevap olarak evet derse, phase 2’ye geçiliyor herhangi bir katılımcı ben bunu yapamam diyorsa, coordinator abort mesajı gönderiyor tüm katılımcılara. Phase 2’de ise hadi şu yaptığınız işlemleri bir commitleyin deniyor.
Ama bu yöntem maalesef kusurlu şöyle ki;
- İlk olarak artık bir Transaction Manager bağımlılığınız mevcut, bu adama bağlı yaşamak zorundasınız. Biz microservis ile bir şeyleri inşa ederken autonomy’den bahsediyorduk değil mi ? Ya şimdi ?
- Resim gördüğünüz üzere; bu işleme başladığınız anda resourcelar locklanıyor ve siz abort mesajı veya commit başarılı olana kadar öyle kalmak durumunda, şöyle düşünün DB-2’da herşey yolunda gitti ama DB-1 bekliyor, bekliyor, bekliyor. Bu durumda locklanan resource kullanılamaz ve availability düştü. Evet her mimari için %100 available diyemeyiz ama overall da bununda bir resource bağlı olarak düşmesini hatta deadlock ve contention’a yaratmasını göze almak istemem.
- Son phase’da gördüğünüz gibi commit işlemi gerçekleştiriyor burada iki farklı sistemin aynı anda commit edeceği garantisi verebilir misiniz ? Veremezsiniz birinin commit zamanı 5sn sürebilir biri 1ms veya daha uzun ve kısa süreler, burdan çıkarımımız evet bir zaman aralığında elimde inconsistent datalar olabilir.
- Sistem tıkır tıkır işlerken Coordinator(Transaction Manager) down oldu, işte o zaman failure modelar ile bazı işlemleri otomatik yapabilirsiniz ama cover edilmeyen case’ler için manuel işlemler yapmak zorundasınız.(Bu hatalarıda anlamlandırmak çok sıkıntılı)
Yukarıdaki nedenlere bağlı olarak bu yapıyı seçmek başınızı çok başınızı ağrıtabilir. Önerilen ise; short-lived operasyonlar için bu yapıyı tercih etmeniz. Alternatif yol ise Sagas.
Sagas
Her microservice ile uğraşan kişi bu kelimeyi ya duymuş ya da duymadıysa iş transaction tartışmasına geldiğinde duyacaktır. Saga Türkçe olarak destan veya hiç bitmeyen bir hikaye gibi düşünebilirsiniz. Akademik makalede isim babası olarak Rafael Alonso, Ricardo Gordon ve anonymous imiş.
Hector Garcia-Molina ve Kenneth Salem bu konu üzerindeki çalışmayı 1987’de yapmışlar, şuan onların yazdığı akademik makalenin günümüze dahil olması çok iyi değil mi?
Neyse konumuza dönecek olursak, bu akademisyenler eğer uygulamanızda long-lived transactionlar varsa bunları, kullanırken bir çok resource’un locklı kalmasından ötürü, verimsizlik oluştuğunu onun için bu LLT’leri küçük parçalara bölerek yönetmenizin mantıklı olacağını söylüyorlar. Yani bu transactionları bağımsız servislere taşıyın ve buralarda handle etmeye çalışın, bu sub transactionları daha küçük sürelerde işleteceğiniz için resource’ları daha etkin kullanmanız demek diyorlar. Aşağıdaki alıntı makalenin sonuç kısmından.
We have presented the notion of saga, a long lived transaction that can be broken up into transactions, but still executed as a unit Both the concept and its implementation relatively simple but in it simplicity lies its usefulness. We believe that a saga processing mechanism can be implemented with relatively little effort, either as part of the DBMS or as an added-on facility The mechanism can then be used by the large number of LLTs that are sagas to improve performance significantly. (Hector Garcia-Molina ve Kenneth Salem, Sagas 1987)
Baştan söylemek gerekirse Saga da size o geleneksel yöntemi veremeyecek, ACID olmayacak. Başka deyişle Atomicity olmayacak. CAP teoremine göre distrubuted bir sistemde size ACID’i verebilecek hiç bir çözüm yok maalesef. Eric Brewer Consistency, Availability ve Partition Tolarence (CAP) teoremi ile bu üçünün aynı anda distributed bir sistemde olmasının mümkün olmadığını söylüyor. Partition tolarence dediğimiz şey aslında microservice’ler. Geriye kabul edeceğimiz ikisi kalıyor ya availability ya da consistency.Bu tamamiyle sizin requirement’larına bağlı olarak vermeniz bir karar.

Geleneksel yollardan yukarıdaki processleri işlettiğimizde, hata alması durumunda commit olmadan önce işlemler geri alabiliyorduk ve tutarsız verinin oluşmasını engelliyorduk fakat mikroservice mimarisinde processleri farklı local transactionlarda adım adım işlettiğimiz için aslında Process3’e gelindiğinde ve bir hata aldığımızda Process2 ve Process1’in yaptığı işlemler commit edilmiş durumda. O zaman yapabileceğimiz şey bu servislerin üstüne işlemleri rollback edecek processleride yazmak(compensating processes) ve hata olduğunda aşağıdaki hangi adımda aldıysak bunları geriye doğru alıp işletmek.
Burada dikkat etmeniz bazı konular var, bunları design aşamasında karar vermek sizlere avantaj kazandırabilir.
- Processleri mantıksal olarak sıralamak sizlere daha rahat bir rollback mekanizması kurmanıza yardımcı olabilir, mesela Process1’in içinde kullanıcıdan işlemi alır almaz işleminizi başarılı bir şekilde bitmiştir mailini göndermek, işlemin Process3’de hata almasıyla sizi üzebilir. Bu processi işlemin en sonunda çağırmak avantaj sağlayabilir. Bunun gibi mantıksal sıralamalar işinize yarayabilir.
- Rollback mekanizmasını kurarken, üzerinde işlem yapılmamış servisin compensating processini çağırmak başka hatalara neden olabilir. Gereksiz çağırım yapmamalıyız.
- Her servisin bir hata dönmesi durumunda tüm rollback mekanizmasını yeniden işletmenize gerek yok, mesela Microservice 2’nin unavailable olması durumunda networkden kaynaklanan anlık bir sorun olabilir bu durumda Microservice 1 retry ederek sorunu çözebiliriz.
Burada farkında olmanız gereken konu şu, compensating processler sisteminizi daha tutarlı bir duruma getirmek için ama hiç bir zaman geleneksel yollara göre daha temiz bir çözüm olmayabilir. Bu sizin iş mantığınıza göre daha karmaşık hale geldiğini göreceksiniz. Çünkü commit edilmiş bir işlemin sonucu olarak uygulamızda neler olup bittiğini iyi bilmelisiniz ve çok geniş bir senaryo bakış açısı ile yazdığınız koda bakmalısınız.
Sorunlara çözmek olmak amacıyla Saga’nında başka uygulama yöntemleri mevcut bunlardan birisi Choreographed Sagas diğer ise Orchestrated Sagas.
Choreographed Sagas
Bu sagada servislerin iletişim kurmaları için ağırlıklı olarak event’ler kullanılır. Bu eventler uygulamanızı loosely-coupled hale getiriyor. Şöyle düşünün siz iş yapan bir servissiniz işlemi bitirdikten sonra bir event fırlatıyorsunuz ve diyorsunuz ki ben bu işi yaptım kim bu işlemin sonucu ile ilgileniyorsa event’imi yakalayıp(subscribe) işlemini yapabilir. Buda işinizi merkezi olarak tutmaktansa dağıtmak anlamına geliyor, servislerin işi alıp kendi logicleri kendilerinin kurması anlamnına geliyor. Burayı parantez açarak bir daha vurgulamak istiyorum işinizi dağıtıyorsunuz kararları başkasına bırakıyorsunuz. Bu avantaj gibi görünsede dezavantajda yaratacaktır.
Kimin beni dinlediğini bilmeme gerek yok, mesela bir zaman aralığında requirement olarak bir istek geldi Process2 bittiğinde şu işlemi yapmalıyız gibi, bu sefer Process2-Event’ine subscribe olmam yeterli o işlemin sonucu olarak bu işi yapacağım ve kimsenin bundan etkilenmesine gerek yok. Diğer bir bakış açısı ile Monolith to Microservice yaparken bu durum sizin daha iyi bir şekilde agile olmanızı sağlar.

Burada işlem Process1 ile başlıyor ve bu işlemin sonucunda servis ben işim tamam diye bir event bırakıyor, daha sonra bu işlemin sonucu ile işi olan diğer servisler bu eventi alıp işliyor. Daha sonra bu işlemlerin sonucunda onlarda event fire ediyorlar son olarak Process4 ihtiyacı olan tüm eventleri alıp işledikten sonra işlemi bitiriyor. Şimdi burada Process4’ün hata aldığında ne yapmamız gerekiyor onuda şekilde anlatalım.

Process4 bir hata aldı ve Process4-Error-Event diye bir event fırlatıyor, daha sonra bunla işi olan her servis bu eventi alarak kendi rollback operasyonlarını gerçekleştiriyor. Bu sagayı impelemente ederken iki yönetimi tercih edebilirsiniz.
- Bir message broker kullanabilirsiniz. Eventi fırlatan tarafta olan için en önemli konu mesajların subscribe olan servislere gerçekten iletip iletilmediği olabilir. Artık message brokerlar reliability ve delivery konusunda çok başarılılar.
- İkinci yol ise; event stream yapıp kullanabilirsiniz.
Güzellikleri olduğu kadar bazı dezavantajlarıda var mesela parça parça hale getirdiğiniz iş mantığınızı yönetmek daha zor olabilir çünkü orchestration yok eventler havada uçuşuyor, tümüyle sistemin nasıl çalıştığını anlamak zorlaşacak bu da maintain etmenizi zorlaştıracaktır. Bu yüzden küçük boyutlu sagalar ve synchronous gerekmeyen uygulamalar için tercih etmek mantıklı olabilir.
Orchestrated Sagas
Bu sagada yapacağımız bir iş için orchestrator(coordinator) bulunmakta ve katılımcılara(particiapants) ne yapması gerektiğini söylemekte. Bunu bir flow engine gibi düşünebilirsiniz. Arada bir message broker olduğunu düşünün buradan bir event fırlatılıyor(bir mesajı queue yazmak) ve bunun sonucu olarak orchestrator cevapları bekliyor, aldığı cevapları bir saga log’una yazıyor daha sonra bir sonraki action ne olması gerekiyorsa o eventi message brokere’a söylüyor. Tüm işlem bu şekilde bitiriliyor.
Bu yönetem ile uygulamamızı manage etmek ve maintain etmek daha kolaylaşıyor, çünkü işlerin yönetim sırasını biliyorsunuz hataları daha kolay track ve rollback edebileceğiniz bir saga logunuz mevcut çünkü tek bir noktada bunu topluyorsunuz. Bir önceki yapıda event queue’ya bıraktığımız eventleri servislerin kendileri değerlendirmek zorunda kalırken bu işi servise bırakmadan sırayla nasıl çalışması gerektiklerini biliyorlar buna göre kodunuzu implement ediyorsunuz.
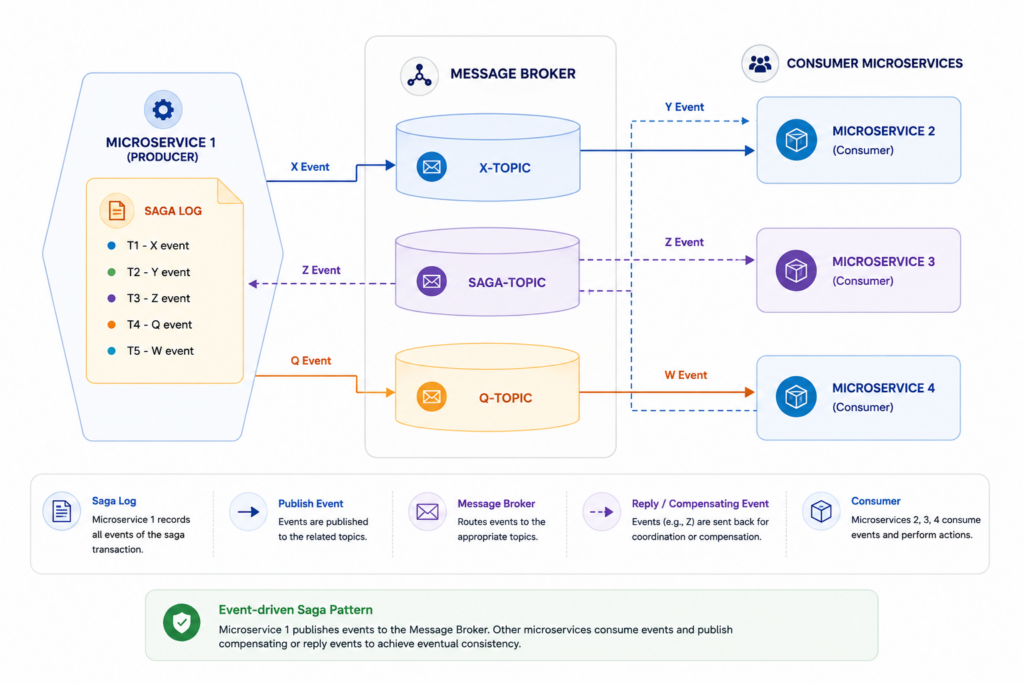
Şekilde gördüğümüz gibi X eventi topiclere konuyor ve subscribe olan servisler kendi işlerini yapıyor, daha sonra işleri biten servisler kendi eventlerini yazıyor, bunlar sırayla Saga Loguna ekleniyor daha sonra orchestrator bir sonraki actionı tetikliyor ve tüm süreç bitene kadar devam ediyor.
Gördüğünüz gibi çok fazla şeyin orchestrator tarafından bilinmesi gerekiyor.Buda bize bir takım risklerle dönüyor mesela single point of failure. Orchestrator down olursa, retry olaylarını çok güzel kurgulamak gerekiyor. Burada tamamiyle loose coupling’den bahsedemeyiz, ama less coupling bir ilişki olduğunu söyleyebiliriz.Okuduğum kaynaklarda gördüğüm kadarıyla en çok tercih edilen ve development takımlarının daha kolay uyum sağladığı yöntem orchestrated saga yöntemiymiş.
Sonuç olarak bu yöntemlerin her birinin bir birine göre avantaj ve dezavantajları mevcut, kişisel bir tercih olarak microservice olarak servislerimi geliştirirken kullanmayacağım yöntem 2PC olurdu bu benim kişisel tercihim olurdu, yukarıda nedenlerini yazdım. Hangisi sagayı kullanmam gerektiğine kesinlikle requirementlarıma göre karar verirdim ve sadece bir tek saga yöntemini tüm uygulamamda uygulamazdım. Hangi yöntem daha çok fit ediyorsa onu oraya koymaya çalışırdım tabi bunu requirementlarıma göre yapardım.
Kaynaklar:
https://learning.oreilly.com/library/view/microservices-patterns/9781617294549/kindle_split_012.html (Chris Richardson) Bu kitap çok daha güzel örneklerle step by step olayları çok daha detaylı anlatıyor üstelik implementation konusunda da örnekler paylaşıyor. Yazarın tarzıda çok güzel, ya bu konu ne olacak peki dediğiniz yerde aslında oda düşünmüş ve cevap veriyor.
https://learning.oreilly.com/library/view/microservices-in-action/9781617294457/c05.xhtml (Paulo A Pereira; Morgan Bruce) Bu kitap karmaşık bir konu olan bu yöntemi olabilecek en basit haliyle anlatmış göz atmanızda fayda var bence.
https://learning.oreilly.com/library/view/monolith-to-microservices/9781492047834/ch04.html#ch05-transactions (Sam Newman) Diğer bir temiz anlatımda bu kitapda, bu kişi danışmanlık verirken doğrudan bu problemlere maruz kaldığı için bir göz atıp deneyimlerini almakta faydalı olabilir.
https://learning.oreilly.com/library/view/designing-data-intensive-applications/9781491903063/ch09.html#sec_consistency_2pc (Martin Kleppmann)
https://www.academia.edu/2356145/Sagas (Hector Garcia-Molina ve Kenneth Salem, 1987)
https://robertleggett.blog/2019/03/17/when-should-you-choose-choreography-vs-orchestration-for-your-microservices-architecture (Benefits ve Challenges için çok daha net bir bakış açısı kazandırabilir)