Basic Hashing ve Consistent Hashing Mantığı
Distributed sistemleri incelerken bir verinin farklı sunucular (node) üzerine nasıl dağıtıldığını araştırırken oldukça ilginç bir algoritmayla karşılaştım: Consistent Hashing.
Ancak Consistent Hashing’e geçmeden önce problemi anlamamız gerekiyor. Bunun için önce klasik yöntem olan Basic Hash Function yaklaşımına bakalım.
Basic Hash Function
Elimizde dört adet sunucu (Node) olduğunu düşünelim.
Verilerimizi aşağıdaki anahtarlarla sisteme yerleştireceğiz.
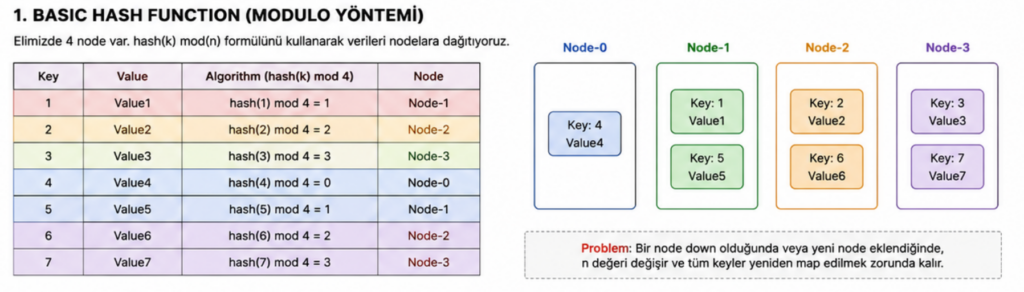
Klasik yöntemde kullanılan formül oldukça basittir.
Node = hash(key) % nodeCountBurada;
- key → dağıtılacak veri
- nodeCount → sistemdeki toplam node sayısıdır.
Bizim örneğimizde;
nodeCount = 4olduğu için hesaplamalar üsteki şekildeki gibidir.
Bu yöntem oldukça hızlıdır. İstediğimiz herhangi bir anahtarın hangi node üzerinde olduğunu tek bir hesaplamayla bulabiliriz. Ancak burada önemli bir problem vardır.
Problem Nerede?
Şimdi Node-2’nin sistemden çıktığını düşünelim.
Artık sistemimizde sadece üç node kaldı.
hash(key) % 3hesabı yapılacaktır.
Bu durumda yalnızca Node-2 üzerindeki veriler değil, hemen hemen bütün anahtarlar farklı sunuculara taşınacaktır.
Örneğin;
hash(3)%4 = Node-3

iken

hash(3)%3 = Node-0olacaktır. Yani milyonlarca anahtar yeniden hesaplanmalı ve farklı sunuculara taşınmalıdır.Dağıtık sistemlerde en büyük maliyetlerden biri de budur.
Consistent Hashing
Bu problemi çözmek için Consistent Hashing geliştirilmiştir.
Bu yaklaşımda artık node’lar doğrusal bir liste yerine bir hash halkası (Hash Ring) üzerine yerleştirilir.
Aşağıdaki şekil temel mantığı göstermektedir.
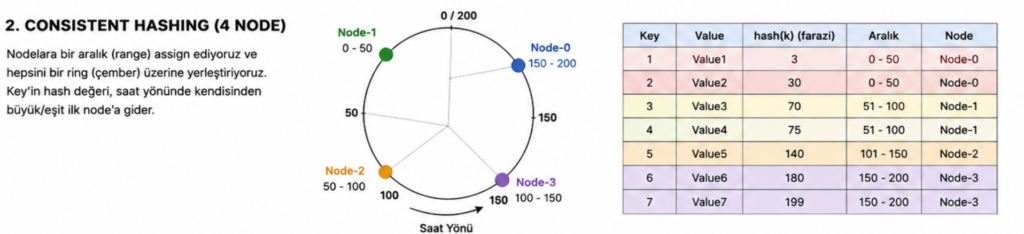
Şekilde görüldüğü gibi;
- Mavi noktalar sunucuları (Node)
- Turuncu noktalar ise Key değerlerini temsil ediyor.
Hash sonucu oluşan her anahtar, saat yönünde ilerleyerek karşısına çıkan ilk node’a yerleştiriliyor.
Örneğin;
Key 35hash sonucu Node-0’ın bulunduğu aralığa düştüğü için Node-0’a gider. Benzer şekilde;
Key 180Node-3’e yerleşecektir.
Node Eklendiğinde Ne Olur?
Şimdi sisteme yeni bir node eklediğimizi düşünelim. Basic Hashing yönteminde bütün verilerin yeniden dağıtılması gerekiyordu. Consistent Hashing’de ise durum tamamen farklıdır.Yeni node yalnızca kendi sorumlu olduğu aralıktaki anahtarları devralır.
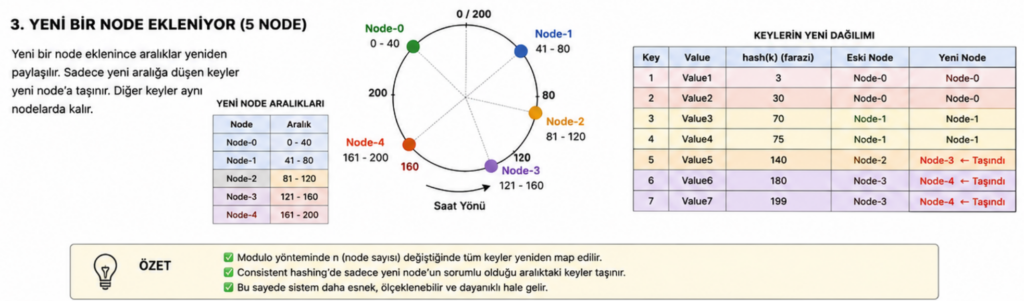
Örneğin;
Node-4eklendiğinde yalnızca;
160 - 200aralığındaki key’ler yeni node’a taşınacaktır. Diğer milyonlarca kayıt olduğu yerde kalır. Bu yüzden sistem çok daha az veri taşır ve yeniden dağıtım maliyeti ciddi şekilde azalır.
Avantajları
Consistent Hashing’in en büyük avantajları şunlardır:
- Node eklendiğinde yalnızca ilgili anahtarlar taşınır.
- Node kaldırıldığında yine sadece ilgili bölüm yeniden dağıtılır.
- Tüm sistem yeniden hash edilmez.
- Büyük ölçekli sistemlerde çok daha verimlidir.
- Ölçeklenebilirliği oldukça yüksektir.
Nerelerde Kullanılır?
Bugün birçok dağıtık sistem bu yaklaşımı veya geliştirilmiş versiyonlarını kullanmaktadır.
Bazı örnekler:
- Apache Cassandra
- Amazon Dynamo / DynamoDB
- Riak
- Redis Cluster
- Hazelcast
- Akamai CDN
- Memcached (Ketama Consistent Hashing)
Sonuç
Basic Hashing küçük sistemlerde oldukça pratik bir yöntem olsa da, node sayısının değiştiği büyük ölçekli dağıtık yapılarda ciddi yeniden dağıtım maliyetleri oluşturur.
Consistent Hashing ise hash uzayını bir halka (ring) olarak modelleyerek yalnızca etkilenen anahtarların taşınmasını sağlar. Bu sayede milyonlarca kaydın yeniden hesaplanmasının önüne geçilir ve sistemler çok daha kolay ölçeklenebilir hale gelir.
📚 Kaynaklar
- David Karger et al. Consistent Hashing and Random Trees
- Amazon Dynamo Paper
- Apache Cassandra Documentation
- Riak Documentation
📦 Bu yazı dağıtık sistemler konusunu öğrenme sürecimde hazırladığım temel bir özet niteliğindedir. Günümüzde Cassandra, DynamoDB, Riak, Redis Cluster, Hazelcast ve benzeri sistemlerde Consistent Hashing’in daha gelişmiş varyasyonları (virtual nodes, replication, rendezvous hashing vb.) kullanılmaktadır. Buradaki amaç algoritmanın temel mantığını anlatmaktır.
temel ve açıklayıcı bir anlatım olmuş ellerinize sağlık.